JVM8 结构
本篇翻译自 Oracle 官方文档 —— JVM 规范第二章,并包含删减及译者解读。如果不打算深入了解,那么仅需要阅读总结好的 TLDR 部分即可。
TLDR
Java 语言与 JVM 并没有直接联系,它们之间的关联是通过将 Java 源码编译为字节码文件,随后 JVM 执行字节码文件而间接关联的。目前已有多种基于 JVM 平台的开发语言,如 Kotlin Scala 等,它们都可以通过其编译器最终产生字节码文件。也就是说 JVM 的规范是更高一级的虚拟机抽象,不针对任何特定开发语言,只要某种开发语言能正确产生 JVM 能理解的字节码即可。
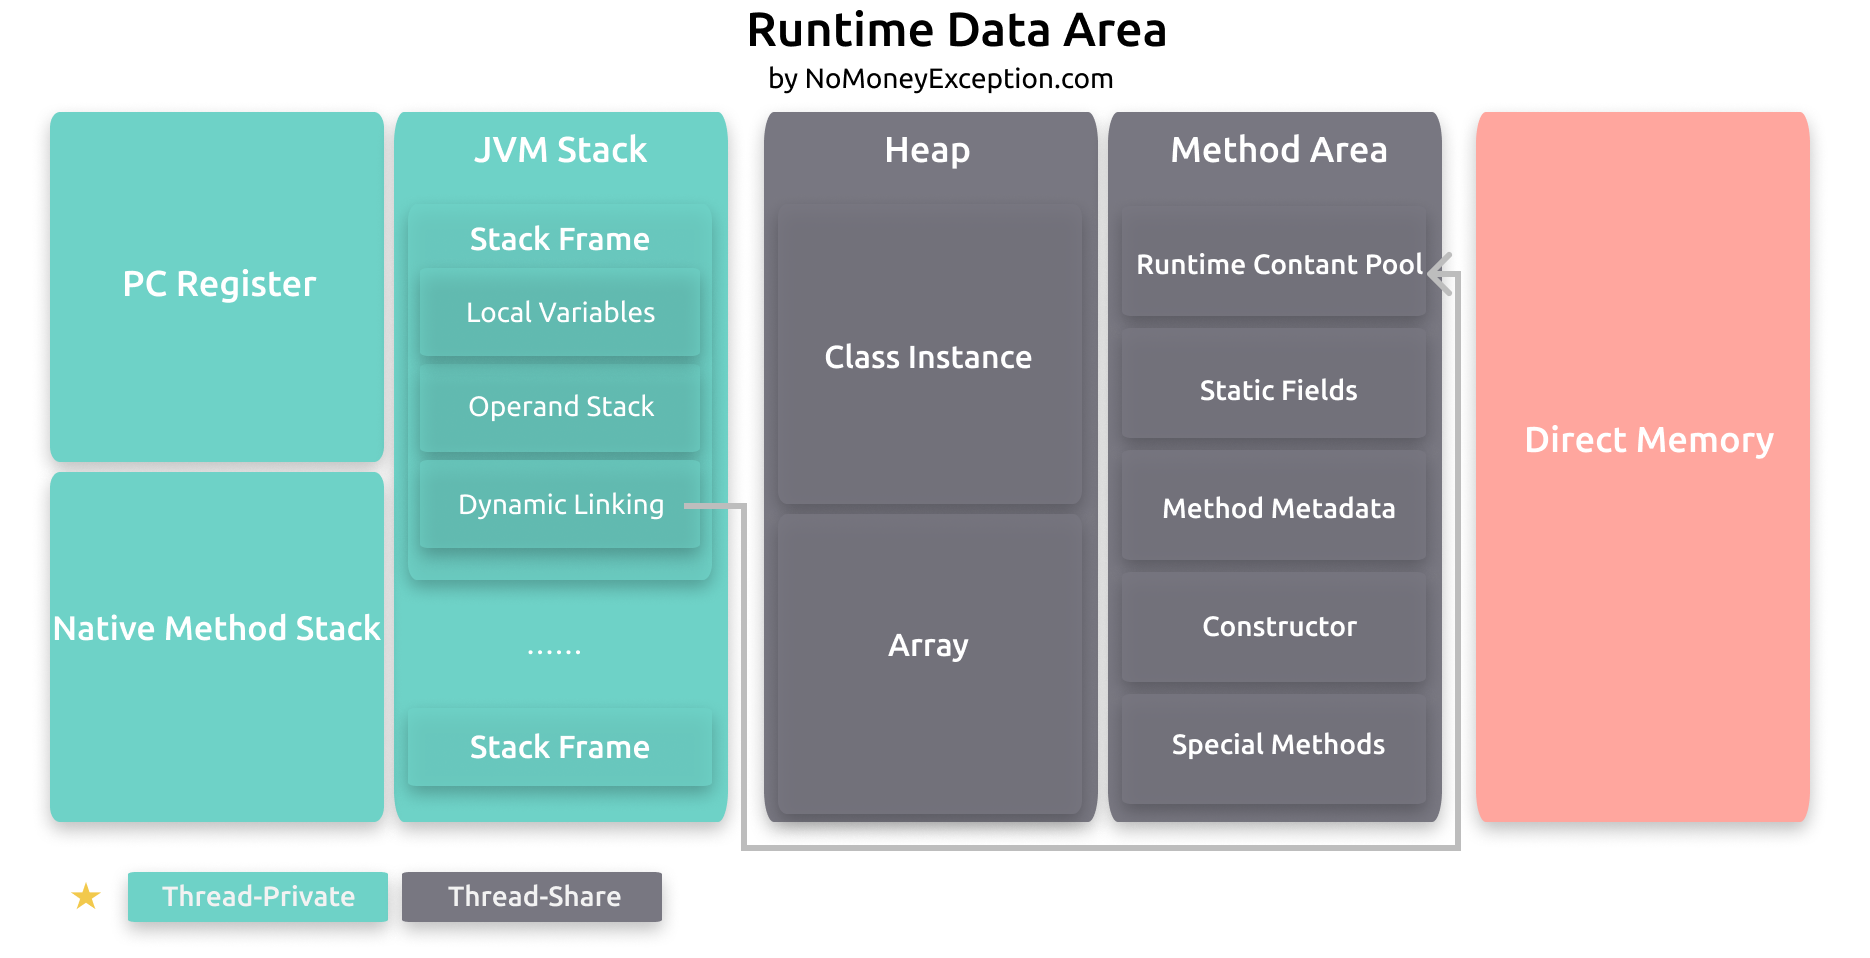
在 JVM 规范中,并没有针对运行时的内存布局进行规定,下面的图是 HotSpot 虚拟机在实现 JVM 标准时自由设计的。JVM 的实现,目前常用的是:HotSpot OpenJ9 等,更详细的说明可以参考维基百科。
JVM 规范也没有规定使用何种垃圾回收算法,下表是 HotSpot 虚拟机设计的部分垃圾回收算法及其具体实现的垃圾回收器。
| 算法 | 实现 |
|---|---|
| 复制 | Serial ParNew Parallel Scavenge |
| 标记整理 | Parallel Old |
| 标记清除 | Concurrent Mark Sweep |
| 其他 | G1宏观基于标记整理,局部基于复制 |
JVM 执行的是字节码,而不是 Java 代码,比如以下代码:
|
将被编译成:
|
可以看出,在 Java 代码编译之后,其操作数的类型已经确定,并且已经使用了特定类型的指令(ILOAD 中的 I 代表整形)。
boolean byte short char int 几种类型通常都统一使用 int 的指令集来执行操作,比如:
|
将被编译成:
|
与 int 指令的区别仅在于返回时多了一个 I2C 转换指令。
异常的抛出流程:将沿着调用链一直向外抛出,如果一直没有找到对应的异常处理器,那么抛出异常的线程将被终止执行;如果找到对应的异常处理器,那么使用该处理器处理异常。
文档正文
本文档详述了一种抽象的虚拟机,而不是某个虚拟机的具体实现。
为了正确地实现 JVM,只需要读取 class 字节码文件,然后正确地执行其中指定的操作即可。规范中没有描述到的部分,实现者都可以自由发挥。比如运行时数据的布局、垃圾回收算法的使用及 JVM 指令的内部优化(比如将 JVM 指令直接翻译为机器指令)等,都留给实现者自由决定。
1. class 文件格式
编译后被 JVM 用来执行的代码使用了一种硬件及操作系统无关的二进制格式,通常(并不绝对)保存在被称为字节码文件(.class)的文件之中。字节码文件严谨地定义了类或者接口的具体表现,包括平台相关的字节序等细节。
2. 数据类型
与 Java 语言中的数据类型一致,JVM 操作的类型有两类:原始类型和引用类型。相应的,两种数据类型的值都可以被保存在变量中、当做参数传递及当做方法的返回值。
JVM 期望几乎所有的类型检查都在执行之前完成,通常是编译器,而不是 JVM 自己。在运行时,不需要标记基本类型的值,也不需要对其进行检查以确定它们的类型,或者将它们与引用类型区分开来。相反地,JVM 的指令集使用类型专用的指令来区分其数据类型,比如:iadd ladd fadd dadd 都是 JVM 用来获取两数相加之和的指令,但它们每一个都只针对特定的数据类型:int long float double,下面的内容将会描述这些 JVM 支持的类型及指令。
JVM 包含了对对象的显式支持。一个对象,要么是动态分配的类实例,要么是一个数组。引用的值可以想象为指向对象的指针,对一个对象可以同时有多个引用。对象总是通过引用的值来进行操作、传递及测试。
3. 原始类型及取值
JVM 支持的原始类型有如下几种:数值类型、布尔类型和 returnAddress 类型。
数值类型包括整形和浮点型。
整形包括:
byte, 8 位(8-bit)有符号二进制补码,默认值为 0short, 16 位(16-bit)有符号二进制补码,默认值为 0int,32 位(32-bit)有符号二进制补码,默认值为 0long,64 位(64-bit)有符号二进制补码,默认值为 0char,16 位(16-bit)无符号整数表示Unicode 码点,UTF-16编码,默认值为空码点\u0000
浮点型包括:
float,单精度浮点数,默认值为 正0double,双精度浮点数,默认值为 正0
布尔类型包括 true 和 false,默认值为 false。尽管 JVM 定义了布尔类型,但它只提供了十分有限的支持:没有专门操作布尔类型值的虚拟机指令。相反地,Java 语言中对布尔类型的操作在编译时修改为对 int 的操作。JVM 直接支持了布尔类型数组,newarray 指令可以直接创建布尔数组,对于布尔数组的存取操作则是使用了字节数组(byte array)的指令:baload 和 bastore。在 Oracle 的虚拟机实现(HotSpot)中,布尔数组被编码为了字节数组,数组中的每个布尔元素用一个字节来替代(8 bits)。
returnAddress 类型是一个指向字节码指令的指针,在所有的原始类型中,只有 returnAddress 不能在 Java 语言中直接使用,它只在 JVM 的 jsr ret jsr_w 中使用。
4. 引用类型及取值
引用类型有三种:类类型、数组类型和接口类型。他们的值分别指向了动态创建的类实例、数组实例或实现接口的类实例及实现接口的数组实例。
数组类型包含了一个单一维度的组件类型,称为数组的元素类型。一个数组的元素类型必须为原始类型、类类型或接口类型中的一种。
引用类型的值还可以是特殊的 null,表示不指向任何对象。null 引用没有运行时的类型,但是可以转换为任何类型,其默认值为 null。JVM 规范没有强制指定 null 的值。
5. 运行时数据区
JVM 为一个程序的执行过程定义了许多运行时数据区,其中一部分在 JVM 启动时创建在 JVM 退出时才销毁,其他数据区域则是线程专属的,随线程而生,随线程而亡。
5.1 pc 寄存器
JVM 支持多线程同时执行,每个线程都有其专属的 pc(Program Counter) 寄存器。在任意时间,每个线程都在执行一个单独的方法,也就是该线程的当前方法。如果该方法不是 native 的本地方法,那么 pc 寄存器中保存了当前执行的指令的地址;如果该方法是 native 的本地方法,那么 pc 寄存器为空。pc 寄存器的范围足够在任意的系统平台上存放一个 returnAddress 或本地指针(native pointer)。
5.2 JVM 栈
每个 JVM 线程在创建时都伴随了一个私有的 JVM 栈,JVM 栈保存栈帧。JVM 栈和其他语言中的栈一样,它保存本地变量和部分返回值,在方法的执行和返回中承担作用。因为 JVM 栈除了 push 和 pop 以外不会直接操作,所以它有可能被分配在堆(Heap)上,栈内存空间也不必是连续的。
JVM 规范允许 JVM 栈数量可以为固定大小或者动态伸缩,有以下异常条件与之关联:
- 固定大小:如果一个线程需要的栈空间超过了 JVM 允许的大小,则 JVM 抛出
StackOverflowError错误; - 动态伸缩:如果 JVM 无法满足一个线程所需的栈空间,则 JVM 抛出
OutOfMemoryError错误。
5.3 堆
JVM 在启动时创建一个所有线程共享的堆(Heap)空间,所有的类实例和数组都分配在其中。堆空间由 自动存储管理系统(通常是 Garbage Collector 即垃圾回收器)回收,其中的对象无法显式地销毁。堆空间可以不连续。
JVM 的实现需要提供可以让使用者进行设置的堆初始大小参数,如果堆可以动态伸缩,还必须提供堆的上下限大小参数。
如果 自动存储管理系统 无法提供足够的空间时,JVM 抛出 OutOfMemoryError 错误。
5.4 方法区
JVM 在启动时创建一个所有虚拟机线程共享的方法区,它类似于其他编译型语言生成的 text 段。在其中保存了每个类各自的结构,包括:运行时常量池、字段、方法数据、构造器、特殊方法(§9)以及方法中的指令。
尽管方法区是堆的一个逻辑部分,简单的实现可以选择不进行垃圾回收或者压缩该部分。JVM 规范没有强制指定方法区的位置,以及如何管理那些编译后的代码。方法区与堆一样,可以为固定大小或动态伸缩,且空间也可以不连续。
JVM 的实现需要提供可以让使用者进行设置的方法区初始化大小,如果方法区可以动态伸缩,还必须提供方法区上下限大小参数。
如果该区域运行时请求的大小无法满足,则 JVM 抛出 OutOfMemoryError 错误。
5.5 运行时常量池
运行时常量池是每个类或接口用来存放字节码文件中定义的 constant_poll 表的区域,其中包含了几种类型的常量,范围从编译时已知的数值字面量到运行时方法和字段的引用。运行时常量池类似于其他编译型语言中的符号表(Symbol Table)。
每个运行时常量池都分配在 JVM 的方法区,而且在类或接口被 JVM 创建时初始化。
当创建一个类或接口时,方法区无法满足创建它的运行时常量池所需空间时,JVM 抛出 OutOfMemoryError 错误。
在第五章将描述运行时常量池的初始化。
5.6 本地方法栈
JVM 的实现可能会使用到传统的栈,即 C栈,来支持本地方法(使用 Java 以外的语言写的方法)的执行,当 JVM 的实现用其他语言(如 C)来实现时,也会用到本地方法栈。不能加载本机方法且本身不依赖于传统堆栈的Java虚拟机实现不需要提供本地方法堆栈。如果提供,则通常在创建每个线程时为每个线程分配本地方法堆栈。
同 JVM 栈一样,本地方法栈允许为固定大小或者动态伸缩,有以下异常条件与之关联:
- 固定大小:如果一个线程需要的本地方法栈空间超过了 JVM 允许的大小,则 JVM 抛出
StackOverflowError错误; - 动态伸缩:如果 JVM 无法满足一个线程所需的栈空间,则 JVM 抛出
OutOfMemoryError错误。
6. 栈帧
栈帧用于保存数据和部分结果,也用于执行动态链接(Perform dynamic linking)、为方法返回值(Return values for method)和分发异常(Dispatch exception)。
栈帧在方法执行时创建,在方法执行结束时销毁,无论是正常结束还是异常结束(方法抛出了未捕获的异常)。创建栈帧的线程将栈帧分配到了该线程所对应的 JVM 栈中,也就是线程私有的。每个栈帧都有专属的局部变量表、专属的操作数栈,和一个当前方法所属类中的运行时常量池。
局部变量表和操作数栈各自的大小在编译时就已经确定,栈帧关联方法的 Code 属性也是同样。因此栈帧数据结构的大小仅与具体的 JVM 实现有关,这些结构的内存可以在方法调用中同时分配。
在一个线程之中,只有当前正在执行的方法所对应的栈帧是活动的,这个栈帧被称为当前帧,正在执行的方法被称为当前方法,方法所处的类被称为当前类。对局部变量表和操作数栈的操作仅针对于当前帧。
如果当前栈帧对应的方法调用了其他方法,或者当前栈帧执行结束,那么它就不再是当前帧了。当一个新的方法被调用,一个新的栈帧就被创建出来,控制权移交给新方法的同时,当前帧的概念也一并移交了。在方法返回时,当前帧将回传方法的结果到前一个栈帧,如果存在前一个栈帧的话,接下来当前帧被丢弃,前一个栈帧变为当前帧。
注意,线程创建的栈帧为其私有的数据,无法被其他线程引用。
6.1 局部变量表
每个栈帧都包含一个被称为局部变量表的变量数组,它的长度在编译时就已经确定,并存储在字节码文件中类或接口的方法定义的 Code 属性中。
单个的局部变量可以保存 boolean byte char short int float refrence returnAddress 类型的值,一对局部变量可以保存 long 或者 double 类型的值。
局部变量表是索引寻址的,其索引范围从 0 到局部变量表大小。long 或者 double 类型的值占用了两个连续的局部变量,这样的值只能用较小的索引来访问。比如,一个 double 变量的值占用了 n 和 n+1 的位置,在此情况下,索引 n+1 无法被单独读取,但是却可以写入。写入将导致索引 n 的值无效。
JVM 并不要求 n 一定为偶数,从直观的角度来看,long 和 double 类型的值不需要在局部变量表中对齐 64 位,实现者可以自由地采取一个合适的方法。
JVM 在方法调用时使用局部变量来接收参数。当一个类方法被调用时,所有的局部变量被连续地接收参数传入;在类实例方法调用时,索引为 0 的局部变量总是指向当前被调用的对象实例(也就是 Java 语言中的 this)。
6.2 操作数栈
每个栈帧都包含一个被称为操作数栈的后进先出队列。与局部变量表类似,操作数栈的深度在编译时就已经确定。
在明确上下文的情况下,我们简称当前栈帧的操作数栈为操作数栈。
在栈帧创建时,操作数栈初始化为空。JVM 提供了指令来读取常量、局部变量或实例字段到操作数栈中。还有一些 JVM 指令从操作数栈获取操作数,执行操作,然后将执行结果压回操作数栈中。操作数栈同样也用于准备传递到方法的参数和接收方法的返回值。
比如:iadd 指令使得两个 int 值相加,它要求准备进行相加操作的两个 int 值处于操作数栈的顶部,两个 int 值都被弹出(pop),相加后将它们的和压回操作数栈中。
操作数栈中的每一项都可以保存任何 JVM 中的类型,包括 long 和 double 类型。
操作数栈中的值必须按照它们对应的类型来进行操作,例如,不可能将两个 int 值压入操作数栈中,然后将它们当做 long 来处理,也不能将两个 float 值压入操作数栈中,然后用 iadd 指令将它们相加。少数 JVM 指令(dup swap)在运行时数据区域执行操作时忽略其所操作的值的类型,这些指令被定义为无法修改或拆分单个值。这些对操作数栈的操作限制是在 class 文件验证时实现的。
在任何时间点,操作数栈都有一个关联的深度,其中 long 和 double 占用两个单位的深度,其他值占用一个。
6.3 动态链接
为了支持方法代码的动态链接,每个栈帧都包含了一个对当前方法运行时常量池(§5.5)的引用。一个方法的字节码通过符号引用指向了被调用的方法和被访问的变量。动态链接翻译这些符号引用到实际的方法引用,在遇到未知的符号时加载对应的类,然后将变量访问转换为与这些变量的运行时位置相关联的存储结构中的适当偏移。
方法和变量的后期绑定使得方法调用的其他类在进行更改时不会本地的方法和变量造成影响。
6.4 正常方法调用结束
正常方法调用结束指的是,在调用过程中,没有直接从 JVM 抛出或从代码中显式抛出异常。当前方法正常调用结束时,将返回值返回给调用它的方法。当被调用的方法执行一个返回指令(§11.8)时发生这种情况,返回指令的选择必须适合被返回的值的类型(如果有的话)。
当前帧用来恢复调用者的状态,包括它的局部变量和操作数栈,然后 pc 寄存器适当递增,跳过刚刚执行的方法指令。随后,程序获取到方法返回值并压入操作数栈后继续执行。
6.5 异常方法调用结束
异常方法调用结束指的是在方法执行过程中 JVM 抛出了该方法没有进行处理的异常。执行 athrow 指令还会导致显式抛出异常,如果该异常未被当前方法捕获,则会导致方法调用的突然结束。突然结束的方法调用永远不会将值返回给其调用者。
7 对象的表示
JVM 没有强制要求对象特定的内部结构。
在一些 Oracle 实现的 JVM 中,对类实例的引用是指向句柄的指针,而句柄本身就是一对指针:其中一个指向了包含对象方法和对象类型的表,另一个指向了对象实际分配的堆内存地址。
8 浮点运算
(浮点运算对于普通开发者来说理解起来过于艰难,暂时忽略)
9 特殊方法
在 JVM 层面,每个 Java 语言中的构造函数都显示为一个特殊的实例初始化方法:<init>,这个名称是由编译器指定的。这个方法无法被 Java 语言直接使用,因为<init>不是一个有效的标识符。它只能在 JVM 内部通过 invokespecial 指令来调用,且只能在未初始化的类实例上调用。实例初始化方法与其派生的构造函数的访问权限一致。
一个类或接口最多有一个类或接口初始化方法,而且它们的初始化都必须通过这个方法的调用来进行。类或接口的类或接口初始化方法名称均为 <clinit> 且没有参数和返回值。
实例初始化方法
和类初始化方法的执行时机不同, init在实例化一个对象时调用,而clinit在 JVM 类加载器加在该类时调用。
在 51.0 以后的字节码版本中,类或接口初始化方法必须以 ACC_STATIC 标志进行标记。
即 Java SE 1.7 以后,
方法必须为 static
<clinit> 方法同样由编译器提供,同样也不能显示地在 Java 程序中调用,甚至不会在 JVM 中由指令进行调用;它仅在类加载器加载该类时执行。
10 异常
异常在 JVM 中的表现形式为实现了 Throwable 接口的类或其子类的实例。
抛出异常将会立即引发控制权非本地转移,即从异常抛出点转移到异常处理点。
大部分异常都是当前线程执行操作的结果,它们是同步的。相对的,异步的异常可能在程序执行的任何时候抛出。JVM 抛出异常有以下三个原因:
- 显式执行
athrow指令 - JVM 同步检测到异常的执行条件,这些异常仅在以下情况抛出,而不会随意抛出:
- 程序的执行可能会发生异常:
- 当一个操作指令违反 Java 的语义,比如数组的越界访问;
- 当加载或链接时出现错误。
- 导致超过资源的某些限制,比如使用了过多的内存。
- 程序的执行可能会发生异常:
- 异步的异常由以下情况触发:
Thread或ThreadGroup的stop方法被调用;- JVM 的实现出现了内部错误。
stop方法会影响其他线程或者某个线程组里的所有线程,因为它们会在其他线程中的任意时间抛出。JVM 内部错误也被认为是一种异步异常。
JVM 可能允许在异步异常抛出之前继续进行少量的操作。
由于指令重排,可能会导致某些本来顺序排在异常抛出点后的代码被提前执行。
在遵守 Java 语义的情况下,这样的延迟是被允许的,可以让优化后的代码在实际的执行点去检测并抛出异常。
JVM 抛出的异常是明确的:当控制转移发生时,在抛出异常之前执行的所有指令都必须生效。在异常抛出之后不会再有指令被执行。在异常发生时,一些原本处于异常点之后的代码由于优化重排在异常点之前就执行了,那这些优化后的代码必须保证它们的执行在用户层面不可见。
JVM 的中每个方法都有 0 个或多个异常处理器与之关联。异常处理器通过字节码偏移指定了其在方法中的有效范围,描述了其所对应的异常类型,以及指定了处理异常的代码位置。异常处理器与异常的匹配,需要同时检查异常抛出的位置是否在处理器的偏移范围之内,以及类型是否一致或为声明的子类。当抛出异常时,JVM 在当前方法中搜索一个匹配的异常处理器,如果找到,则将控制权转到对应的处理器代码之中。如果没有找到,那么当前方法异常结束(§6.5)。在异常结束时,当前方法的操作数栈和局部变量表都被直接丢弃,当前栈帧被直接弹出,并恢复调用方的栈帧。随后异常在调用方中再次被抛出,继续搜索当前方法中匹配的异常处理,如果没有找到,那就继续弹栈、恢复,继续抛出,直到有对应的异常处理器对它进行处理。如果在到达方法调用链顶部之前没有找到合适的异常处理程序,则终止抛出异常的线程的执行。
在异常处理器中搜索匹配的处理器的顺序非常重要。在一个 class 字节码文件里,异常处理器被保存在一个表中。在运行时,当异常被抛出时,JVM 按顺序从头到尾搜索合适的异常处理器。
注意,JVM 并不强制对方法的异常表条目进行嵌套或排序。Java 的异常处理语义只有与编译器结合才能实现。当以其他方式生成字节码文件时,确保搜索过程与 JVM 实现的行为一致。
最后更新: